Kdo si stahuje váš web a co za to dostanete
Roboti od AI si stáhnou tisíce stránek a pošlou vám jednoho návštěvníka. Tady jsou naměřené poměry a rozhodovací tabulka pro český web včetně Seznamu.
Jarda Pajskr
Váš web si stahují programy, kterým se říká roboti nebo crawleři. Chodí sami, čtou stránky a odnášejí si text. Do léta 2025 to dělaly hlavně vyhledávače a platilo u toho nepsané pravidlo: vezmu si text a pošlu ti za to návštěvníky. U robotů od AI to pravidlo přestalo platit a dá se to změřit.
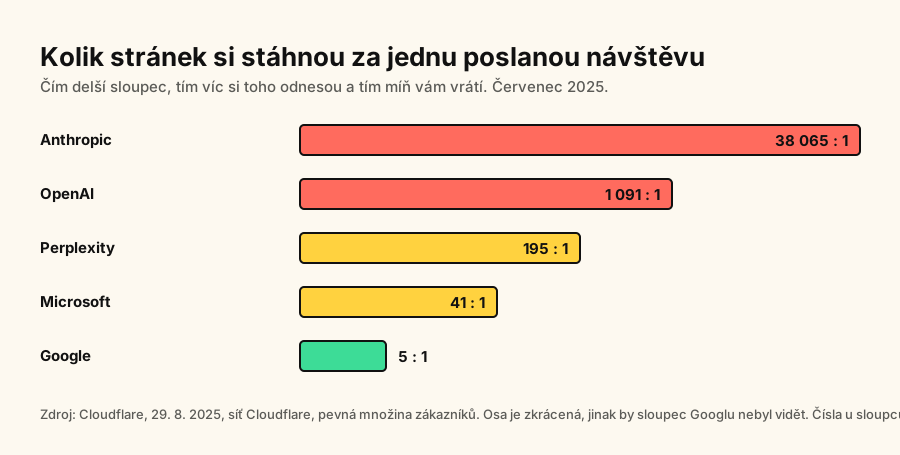
Cloudflare, přes jehož síť teče velká část internetu, spočítal v červenci 2025 u jednotlivých provozovatelů poměr stažených stránek na jednu poslanou návštěvu. Anthropic 38 065 : 1, OpenAI 1 091 : 1, Perplexity 195 : 1, Microsoft 41 : 1, Google 5 : 1 (Cloudflare, 29. 8. 2025). Ze všeho, co roboti od AI stáhnou, jde 79 až 80 % na trénink modelů a 15 až 18 % na vyhledávání.
Přeloženo do češtiny: aby vám z Googlu přišel jeden člověk, stáhne si Google pět vašich stránek. Aby vám jeden člověk přišel od Anthropicu, stáhne si osmatřicet tisíc. To je rozdíl, na kterém stojí celé rozhodování, jestli je pouštět dál.
Nejsou to roboti dva, jsou tři druhy a každý chce něco jiného
Nejčastější chyba, kterou u téhle věci vídám, je házet všechny do jednoho pytle. Přitom se liší v tom, co se s vaším textem stane potom, a to je jediné, na čem záleží.
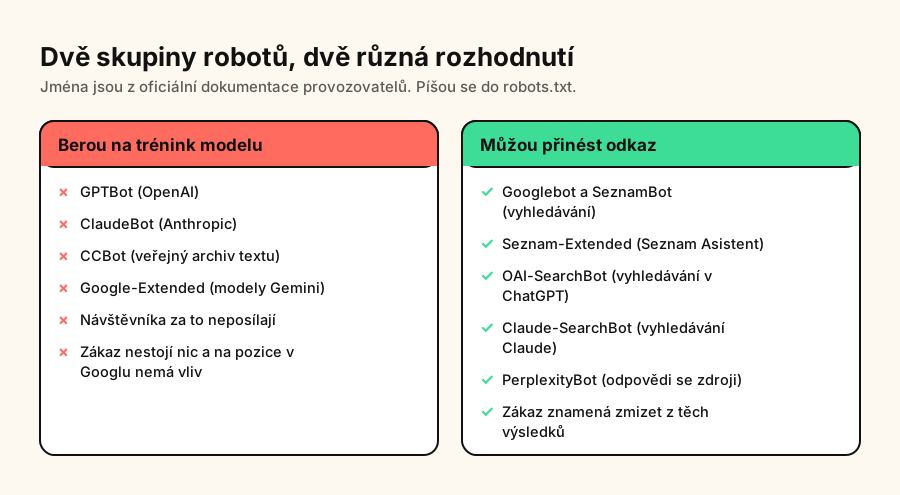
Robot vyhledávače. Stáhne stránku, aby ji mohl nabídnout lidem, kteří něco hledají. Googlebot a SeznamBot. Tenhle vám za text posílá návštěvníky a blokovat ho je způsob, jak zmizet z vyhledávání. Kdo to udělá omylem, čte pak článek o tom, proč Google nenašel jeho web.
Robot na trénink. Stáhne text, aby se z něj model naučil mluvit. Nikdy vám za to nikoho nepošle, protože model pak odpovídá sám a vaše jméno v tom nemusí zaznít. Sem patří GPTBot od OpenAI, který podle jejich vlastní dokumentace sbírá obsah pro trénink základních modelů, ClaudeBot od Anthropicu se stejným popisem, a CCBot, který sbírá text do veřejného archivu, ze kterého berou všichni ostatní.
Robot, který přinese odkaz. Stáhne stránku, aby na ni v odpovědi mohl odkázat. OpenAI na to má OAI-SearchBot, Anthropic Claude-SearchBot, a když se v chatu někdo ptá přímo na vaši adresu, chodí ChatGPT-User a Claude-User. Tenhle druh vám návštěvníka poslat může. Jestli pošle, se pozná v návštěvnosti webu, ne v tomhle článku.
Blokuje se to v robots.txt, jménem robota
Soubor robots.txt leží v kořeni webu a robot se do něj podívá dřív, než začne stahovat. Zákaz pro jednoho konkrétního robota vypadá takhle:
User-agent: GPTBot
Disallow: /
Jak ten soubor funguje a co ještě umí, rozebírám v článku o tom, co robots.txt blokuje a co ne. Dvě věci k němu ale patří i sem. Za prvé: je to prosba, ne zámek. Velcí provozovatelé ji dodržují, protože se k tomu veřejně přihlásili. Robot, který kopíruje obsah načerno, se jménem nepředstaví a tenhle soubor mu je jedno. Za druhé: řádek User-agent: * platí pro všechny naráz. Když pod něj napíšete Disallow: /, zavřete web i Googlu a Seznamu.
Na tohle si Jarda Pajskr dává pozor
Než v robots.txt cokoliv měním, přečtu si nejdřív skupinu pod hvězdičkou. Nejdražší chyba v tom souboru není špatně zakázaný GPTBot, ale řádek Disallow: / pod User-agent: *, protože ten zavře web i Googlu a Seznamu. Zůstává tam nejčastěji po převodu z testovací adresy na ostrou.
Koho pustit a koho ne: rozhodovací tabulka pro český web
Jména robotů jsou z oficiální dokumentace jejich provozovatelů. Doporučení vpravo platí pro běžný firemní web nebo malý e-shop, který chce z internetu zákazníky.
| Jméno v robots.txt | Kdo to je a co s textem udělá | Pustit? |
|---|---|---|
| Googlebot | Vyhledávání Google. Poměr v červenci 2025: 5 stažených stránek na jednu poslanou návštěvu. | Pustit. Zákaz znamená zmizet z Googlu. |
| SeznamBot | Vyhledávání Seznamu. Podle nápovědy Seznamu pravidla v robots.txt respektuje. | Pustit. Seznam je pro české firmy druhý zdroj zákazníků. |
| Seznam-Extended | Robot Seznamu pro odpovědi od AI, tedy pro Seznam Asistenta. Odpovědi uvádějí zdroje a odkazují na ně. | Spíš pustit. Seznam sám píše, že cílem je proklik na váš web. |
| Google-Extended | Trénink modelů Gemini. Google výslovně uvádí, že zákaz neovlivní zobrazení ve vyhledávání ani pozice. | Rozhodnutí je na vás. Zákaz stojí nula a o návštěvy z Googlu nepřijdete. |
| GPTBot | OpenAI, sběr obsahu pro trénink modelů. | Zakázat, pokud vám vadí, že se z vašich textů někdo učí a nic za to neposílá. |
| OAI-SearchBot | OpenAI, vyhledávání uvnitř ChatGPT. Tenhle robot vede k odkazu v odpovědi. | Pustit, jinak se v odpovědích ChatGPT neobjevíte. |
| ClaudeBot | Anthropic, sběr obsahu pro trénink. Poměr v červenci 2025: 38 065 stažených stránek na jednu poslanou návštěvu. | Zakázat, pokud řešíte zatížení serveru nebo vám vadí trénink. |
| Claude-SearchBot | Anthropic, vyhledávání pro odpovědi s odkazem. | Pustit, ze stejného důvodu jako OAI-SearchBot. |
| PerplexityBot | Perplexity, odpovědi s uvedenými zdroji. Poměr 195 : 1. | Pustit. Ze všech amerických je poměr nejmírnější. |
| CCBot | Common Crawl, veřejný archiv textu z webu. Berou z něj další modely. | Zakázat, pokud jste zakázali GPTBota a ClaudeBota. Jinak je to zákaz předními dveřmi a zadní zůstávají otevřené. |
| Applebot-Extended | Apple, trénink modelů. | Rozhodnutí je na vás, dopad na návštěvnost žádný. |
Poměry jsou z měření Cloudflare za červenec 2025 na pevné množině zákazníků, zveřejněno 29. 8. 2025. Nejsou to čísla vašeho webu, jsou to čísla celé sítě.
Co se stane, když je zakážete
Zakázat robota na trénink je legitimní a nic vás to nestojí. Zakázat robota, který nosí odkazy, znamená rozhodnout se, že v odpovědích AI být nechcete. To je taky legitimní rozhodnutí, jen ho musíte udělat vědomě, ne omylem.
Praktická potíž je v tom, že velká část majitelů webů to rozhodnutí už udělala, aniž by o tom věděla. Zákaz do robots.txt zapsala šablona, doplněk nebo hosting. Ve světě to jde vidět na jednom čísle: podíl webů, které mají v robots.txt ClaudeBota, vzrostl od začátku roku 2026 do dubna 2026 z 1,9 % na 3,6 % (Search Engine Land, 6. 4. 2026). České číslo neexistuje, nikdo ho zatím nezměřil.
Dvě věci, které robots.txt neřeší
Zatížení serveru. Když robot stahuje rychleji, než web stíhá, zpomalí se to celé i pro lidi. Zákaz v robots.txt pomůže jen u robotů, kteří ho čtou. Zbytek se řeší na hostingu nebo na síti před webem, tedy tam, kde se dá požadavek odmítnout dřív, než se vůbec dostane k webu.
Souhrny od AI přímo v Googlu. Zákaz pro Google-Extended je jenom o tréninku modelů Gemini. Na to, jestli se váš web ukáže v souhrnu od AI nad výsledky vyhledávání, nemá vliv. Google na to od 31. 8. 2026 nasadil všem webům na světě samostatné nastavení v Search Console, v Nastavení pod položkou o generativní AI ve vyhledávání (nápověda Search Console). Vypnutí znamená, že se váš obsah v těch funkcích neukáže a nebude v nich ani odkaz na vás.
A jedna věc, kterou musím říct nahlas: tenhle nástroj neměří, jestli a jak vás AI ukazuje. Zkontroluje techniku zadané stránky a odhadne návštěvnost z vyhledávání. Kolikrát si vaše stránky stáhl který robot, se dá zjistit jen v záznamech vašeho serveru, tedy na hostingu.
Jarda Pajskr upozorňuje
Když v robots.txt najdete zákaz, který jste tam nedali, nemažte ho hned. Nejdřív zjistěte, odkud se vzal. Bývá to doplněk nebo šablona a ta si ho při příští aktualizaci napíše znovu. Vypíná se to v nastavení toho doplňku, jinak jste za měsíc zpátky tam, kde jste byli.
Jak si to na svém webu projít za deset minut
-
Otevřete si svůj robots.txt
Do prohlížeče napište vasefirma.cz/robots.txt. Uvidíte buď pár řádků, nebo hlášku, že stránka neexistuje. Když soubor chybí, jsou zatím puštění všichni.
-
Najděte řádky User-agent
Každý začíná skupinu pravidel. Projděte je a podívejte se, jestli mezi nimi není jméno, které jste tam nedali. Nejčastěji tam bývá GPTBot z nějakého doplňku.
-
Zkontrolujte hvězdičku
Pod User-agent: * platí pravidla pro všechny. Když je tam Disallow: / a za lomítkem nic, máte zavřený celý web i pro Google a Seznam. To je chyba, ne rozhodnutí.
-
Rozhodněte se u tréninkových robotů
Projděte tabulku výš a doplňte skupiny pro ty, které pustit nechcete. Každá skupina je dva řádky: jméno robota a Disallow: /.
-
Nechte puštěné ty, co nosí odkazy
Googlebot, SeznamBot, Seznam-Extended, OAI-SearchBot, Claude-SearchBot a PerplexityBot. Tohle jsou cesty, kterými se k vám člověk může dostat.
-
Podívejte se do statistik za tři měsíce
V přehledu návštěvnosti webu hledejte zdroje jako chatgpt.com nebo perplexity.ai. Tam uvidíte, jestli vám ti roboti něco skutečně vracejí.
Časté dotazy k robotům od AI
Poznám v návštěvnosti, že mi robot stahuje web?
V běžném přehledu návštěvnosti ne, ten počítá lidi. Roboti jsou vidět v záznamech serveru, které dá hosting, nebo ve statistikách provozu, pokud je hosting nabízí.
Zpomalí mi robot od AI web?
Může, u velkého e-shopu s desetitisíci adresami se to stává. U webu o dvaceti stránkách je to spíš teoretické, protože není co stahovat dokola.
Když zakážu GPTBota, zmizím z ChatGPT?
Z odpovědí, které se opírají o vyhledávání, ne. Na to má OpenAI samostatného robota OAI-SearchBot. GPTBot je podle jejich dokumentace sběr obsahu pro trénink modelů, což je jiná věc.
Blokuje SeznamBot totéž co Googlebot?
Ne. Každý robot čte skupinu se svým jménem, a když ji nenajde, řídí se skupinou pod hvězdičkou. Seznam má navíc samostatné jméno pro odpovědi od AI, Seznam-Extended.
Vyplatí se blokovat úplně všechny AI roboty?
Podle mě ne. Přijdete tím i o ty, kteří v odpovědi uvedou zdroj a odkážou na vás. Rozumnější je zakázat trénink a nechat puštěné vyhledávání.
Dostanu za stažený obsah zaplaceno?
Zatím ne. Existují dohody mezi velkými vydavateli a provozovateli modelů, ale malého webu se to netýká. Proto je to rozhodnutí o tom, co jste ochotní dát zadarmo, ne obchodní jednání.
Kde zjistím, jestli mi robots.txt neblokuje rovnou celý web?
Zadejte adresu do kontroly na téhle stránce. Mezi kontrolami je i robots.txt a výsledek řekne, jestli je web zavřený. Které konkrétní AI roboty tam máte, ale nástroj neposuzuje.
Ověřte si, jestli váš web není zavřený úplně
Zadejte adresu a za půl minuty víte, jestli robots.txt neblokuje celý web, jestli má web mapu a co dalšího brání zobrazení ve vyhledávání. Zdarma.
Napsal
Jarda Pajskr
Weby, SEO a správu webových stránek dělám od roku 2004. Sídlím v Kladně a pracuju po celé republice. Pomáhám webům firem, řemeslníků a e-shopům růst v Googlu i v odpovědích umělé inteligence.