Robots.txt: co opravdu blokuje, co ne a jak si to ověřit
Jeden zapomenutý řádek v tomhle souboru udrží web mimo Google klidně rok. Tady je, co robots.txt umí, co neumí a jak si za dvě minuty ověříte ten svůj.
Jarda Pajskr
Soubor robots.txt je obyčejný textový soubor v kořeni webu, najdete ho na adrese vasefirma.cz/robots.txt. Vyhledávačům v něm říkáte, kam na webu smějí a kam ne. Blokuje jedinou věc: procházení. Neblokuje zobrazení ve výsledcích vyhledávání, nechrání nic před lidmi a s bezpečností webu nemá společného vůbec nic.
Ten rozdíl mezi „projít“ a „zobrazit“ zní jako slovíčkaření, ale stojí za většinou nedorozumění kolem tohohle souboru. A ta úplně nejčastější chyba u malých webů je ještě prozaičtější: v souboru zůstane jeden řádek z doby, kdy se web teprve stavěl a schválně neměl být vidět. Web se pak spustí, majitel čeká zákazníky a Google se na něj celou dobu ani nepodívá.
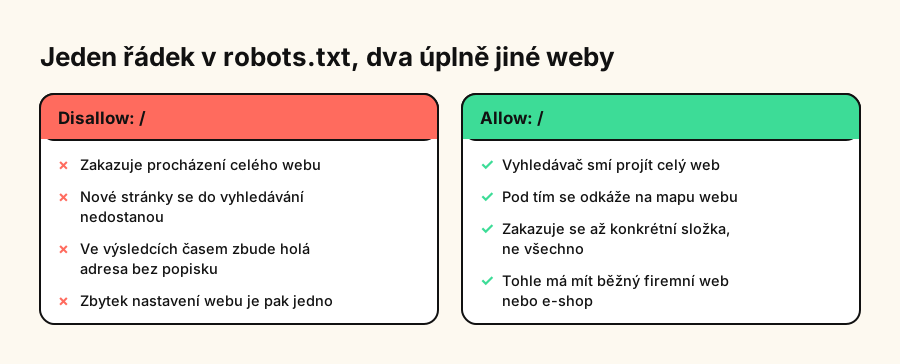
Co robots.txt blokuje a co ne
Vyhledávač dělá s vaší stránkou dvě různé věci a robots.txt mluví jen do té první.
Procházení je stažení stránky. Robot si otevře adresu, načte kód, přečte text. Do tohohle robots.txt mluví: můžeš, nebo nemůžeš.
Zařazení do výsledků je rozhodnutí, jestli se stránka bude zobrazovat lidem, kteří něco hledají. To robots.txt neřídí. Řídí to pokyn v kódu stránky, kterému se říká noindex, a nastavení serveru. Podrobněji o tom píšu v článku Je můj web v indexu Googlu.
Z toho plyne jedna věc, která lidi překvapuje: stránka zakázaná v robots.txt se ve výsledcích objevit může. Když na ni vede odkaz z cizího webu, Google o její existenci ví, jen si ji nesmí přečíst. Ve výsledcích se pak ukáže holá adresa bez popisku, protože nemá z čeho ten popisek poskládat. Vypadá to jako závada a je to logický důsledek toho zákazu.
A naopak: když chcete stránku z výsledků dostat pryč, robots.txt je špatný nástroj. Zakážete jím robotovi přístup, takže si ani nepřečte pokyn, že ji má odstranit. Správné pořadí je nejdřív pokyn noindex do stránky, počkat, až ho Google uvidí, a teprve pak případně zakázat procházení.
Jarda Pajskr upozorňuje
To pořadí si hlídám i u stránek, které ve vyhledávání nechci mít nikdy. Nejdřív noindex do stránky, pak počkat, až si ho Google přečte, a zákaz procházení klidně až za měsíc. Obráceně to skončí holou adresou ve výsledcích, se kterou už nehnete, protože robot dovnitř nesmí.
Nejčastější chyba: v souboru zůstal zákaz z doby stavby webu
Když se web staví, běžně se schválně schová, aby nedodělaná verze nestrašila ve vyhledávání. Ve WordPressu je na to zaškrtávátko v Nastavení, Zobrazování, „Požádat vyhledávače o neindexování webu“. To zaškrtnutí dělá dvě věci naráz: přidá do stránek pokyn noindex a zároveň do robots.txt zapíše zákaz procházení. Web se pak spustí, ale zaškrtávátko odškrtne jen ten, kdo o něm ví.
Druhá cesta ke stejnému konci vede přes vývojovou verzi na adrese typu test.vasefirma.cz. Tam ten zákaz patří. Když se ale web překlopí na ostrou doménu kopií celé složky, překlopí se s ním.
Zákaz celého webu vypadá takhle:
User-agent: *
Disallow: /
První řádek říká „tohle platí pro všechny roboty“, druhý „nesmíš nikam“. To lomítko samotné znamená celý web od kořene dolů. Když za lomítkem něco je, třeba Disallow: /wp-admin/, zákaz se týká jen té složky a je v pořádku.
Pozor na jednu zrádnost: Disallow: úplně bez čehokoliv za dvojtečkou znamená pravý opak, tedy „nezakazuji nic“. Jeden znak dělá rozdíl mezi otevřeným a zavřeným webem, a proto se tenhle soubor nemá psát od oka.
Co který řádek v robots.txt znamená
Soubor se čte po skupinách. Skupina začíná řádkem User-agent a platí až do dalšího řádku User-agent.
| Řádek | Co dělá | Kdy ho chcete |
|---|---|---|
| User-agent: * | Následující pravidla platí pro všechny roboty | Skoro vždy. Místo hvězdičky se dá napsat jméno konkrétního robota. |
| Disallow: / | Zakazuje procházení celého webu | Jen na vývojové verzi. Na ostrém webu je to chyba. |
| Disallow: /admin/ | Zakazuje jednu složku | Na přihlašování do administrace a na části webu, které nemají co dělat ve vyhledávání. |
| Disallow: | Nezakazuje nic | Prázdná hodnota je povolení. Píše se to zřídka, většinou vedle jiných zákazů. |
| Allow: /admin/napoveda/ | Vrací povolení zpět jedné podsložce | Když v zakázané složce potřebujete nechat jednu stránku průchozí. |
| Sitemap: https://vasefirma.cz/sitemap.xml | Odkazuje na mapu webu | Vždycky. Je to nejrychlejší způsob, jak vyhledávači ukázat všechny stránky. |
Řádky Crawl-delay a podobné pokyny na omezení rychlosti Google ignoruje. Rychlost procházení se u něj nastavuje v Search Console, ne tady.
Tři věci, které robots.txt neumí
Nechrání soukromí. Soubor je veřejný, otevře si ho kdokoliv. Když do něj napíšete Disallow: /interni-cenik/, právě jste tu složku inzerovali celému internetu. Co nemá být vidět, se zamyká heslem, ne tímhle souborem.
Není to příkaz, je to prosba. Google, Seznam a další velké vyhledávače ho respektují. Roboti, kteří sbírají e-maily nebo kopírují obsah, ho zpravidla ignorují, protože je k tomu nic nenutí.
Roboty od AI v tomhle souboru zakázat jménem jde a část z nich to respektuje. Než to uděláte, hodí se vědět, kolik stránek si který stáhne a kolik návštěvníků za to pošle zpátky. Naměřené poměry i rozhodovací tabulku má článek o tom, kdo si stahuje váš web.
Nezajistí, že se stránky do Googlu dostanou. Povolení je jen podmínka, ne záruka. Aby vyhledávač o stránkách věděl, potřebuje na ně narazit. K tomu slouží odkazy uvnitř webu a mapa webu, na kterou se z robots.txt odkazuje jedním řádkem.
Mimochodem, tenhle odkaz na mapu webu je jediný důvod, proč mít robots.txt na malém webu, který nic zakazovat nepotřebuje. Když soubor úplně chybí, nic zlého se neděje a vyhledávač web prochází dál. Přijdete ale o nejjednodušší způsob, jak mu mapu webu podstrčit.
Jarda Pajskr doporučuje
Do robots.txt nepíšu jméno žádné složky, kterou nechci mít vidět. Ten soubor si otevře kdokoliv a řádek se slovem cenik nebo zaloha je návod, kam se podívat. Co má zůstat stranou, zamykám heslem na serveru a v robots.txt o tom mlčím.
Jak si svůj robots.txt ověřit za dvě minuty
-
Otevřete si ho v prohlížeči
Do adresního řádku napište vasefirma.cz/robots.txt. Buď se ukáže pár řádků textu, nebo hláška, že stránka neexistuje. Obojí je informace, obojí se dá spravit.
-
Najděte řádek Disallow
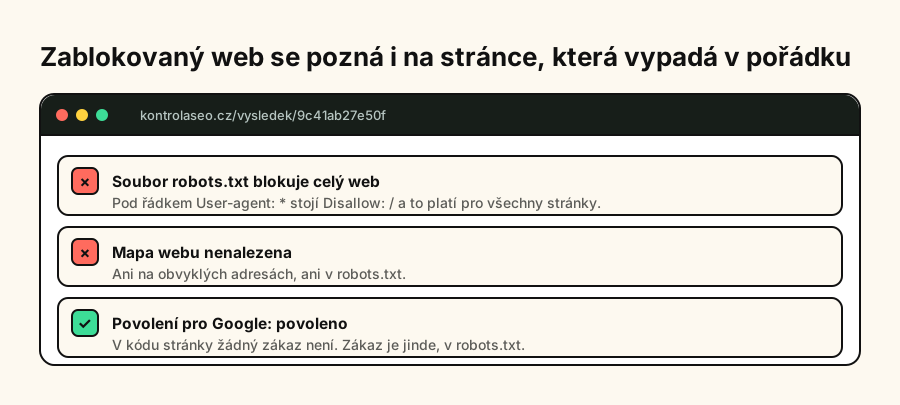
Když pod User-agent: * stojí Disallow: / a za lomítkem nic není, máte zakázaný celý web. Tohle je ten nález, kvůli kterému stojí za to do souboru vůbec koukat.
-
Zkontrolujte, jestli odkazuje na mapu webu
Hledejte řádek začínající slovem Sitemap. Když tam není, přidejte ho na konec souboru i s celou adresou včetně https.
-
Ověřte si to u Googlu
V Search Console je ve zprávě o stavu stránek vidět, které adresy Google zablokoval souborem robots.txt. To je jediné místo, kde uvidíte následky, ne jen obsah souboru.
-
Po opravě si vyžádejte nové projití
V Search Console zadejte adresu úvodní stránky a použijte kontrolu adresy URL a žádost o indexování. Bez toho se čeká, až Google přijde sám, a to bývají týdny.
Jak má vypadat robots.txt běžného firemního webu
U malého webu nebo e-shopu bez zvláštností stačí tohle:
User-agent: *
Allow: /
Sitemap: https://vasefirma.cz/sitemap.xml
Tři řádky. Povolení všem a odkaz na mapu webu. Adresu mapy webu si ověřte tím, že si ji otevřete v prohlížeči, u WordPressu se SEO doplňkem bývá na /sitemap_index.xml.
Na e-shopu se k tomu občas přidává zákaz procházení košíku, přihlašování a stránek s filtry, aby robot nechodil donekonečna po kombinacích velikostí a barev. To má smysl u velkých katalogů. U e-shopu s padesáti produkty je to zbytečná komplikace a snadný způsob, jak si omylem zakázat kategorii, kterou potřebujete ve vyhledávání mít. Duplicitní adresy z filtrů se u malého e-shopu řeší lépe hlavní adresou stránky než zákazem.
Časté dotazy k robots.txt
Musí mít web robots.txt?
Nemusí. Když soubor chybí, vyhledávače web procházejí stejně jako s ním. Přicházíte jen o místo, kde se dá odkázat na mapu webu a kde se dá něco zakázat.
Kam se soubor nahrává?
Do kořene webu, tedy tam, kde je úvodní stránka. Musí být dostupný přesně na vasefirma.cz/robots.txt, na jiné adrese ho vyhledávač nehledá a bude se chovat, jako by neexistoval.
Jak dlouho trvá, než se změna projeví?
Google si soubor stahuje znovu zhruba jednou za den. Zrušení zákazu se ale projeví později, protože pak musí web ještě projít a zpracovat. U malého webu počítejte s dny až týdny, ne s hodinami.
Můžu mít robots.txt na webu bez zabezpečeného spojení?
Můžete, ale pak řešíte větší problém. Web bez https odrazuje návštěvníky ještě dřív, než něco přečtou. Popisuju to v článku o tom, proč web potřebuje SSL certifikát.
Proč se mi ve výsledcích ukazuje stránka, kterou mám zakázanou?
Protože zákaz procházení není zákaz zobrazení. Google o adrese ví z odkazu odjinud, ale nesmí si ji přečíst, takže ukáže adresu bez popisku. Pomůže pokyn noindex, ne další zákaz v robots.txt.
Blokuje robots.txt i Seznam?
Blokuje. Řádek User-agent: * platí pro všechny roboty včetně Seznambotu. Když chcete pravidlo jen pro jeden vyhledávač, napíše se jeho jméno místo hvězdičky a založí se pro něj vlastní skupina.
Kde zjistím, jestli mi robots.txt něco blokuje, když mu nerozumím?
Zadejte adresu webu do kontroly na téhle stránce. Mezi kontrolami je i robots.txt a mapa webu, a výsledek řekne rovnou, jestli je web zavřený, nebo jen chybí odkaz na mapu.
Ověřte si, jestli váš web něco neblokuje
Zadejte adresu a za půl minuty víte, co je v robots.txt, jestli má web mapu a jestli stránce nic nebrání v zobrazení ve vyhledávání. Zdarma a bez registrace.
Napsal
Jarda Pajskr
Weby, SEO a správu webových stránek dělám od roku 2004. Sídlím v Kladně a pracuju po celé republice. Pomáhám webům firem, řemeslníků a e-shopům růst v Googlu i v odpovědích umělé inteligence.